
项目概述
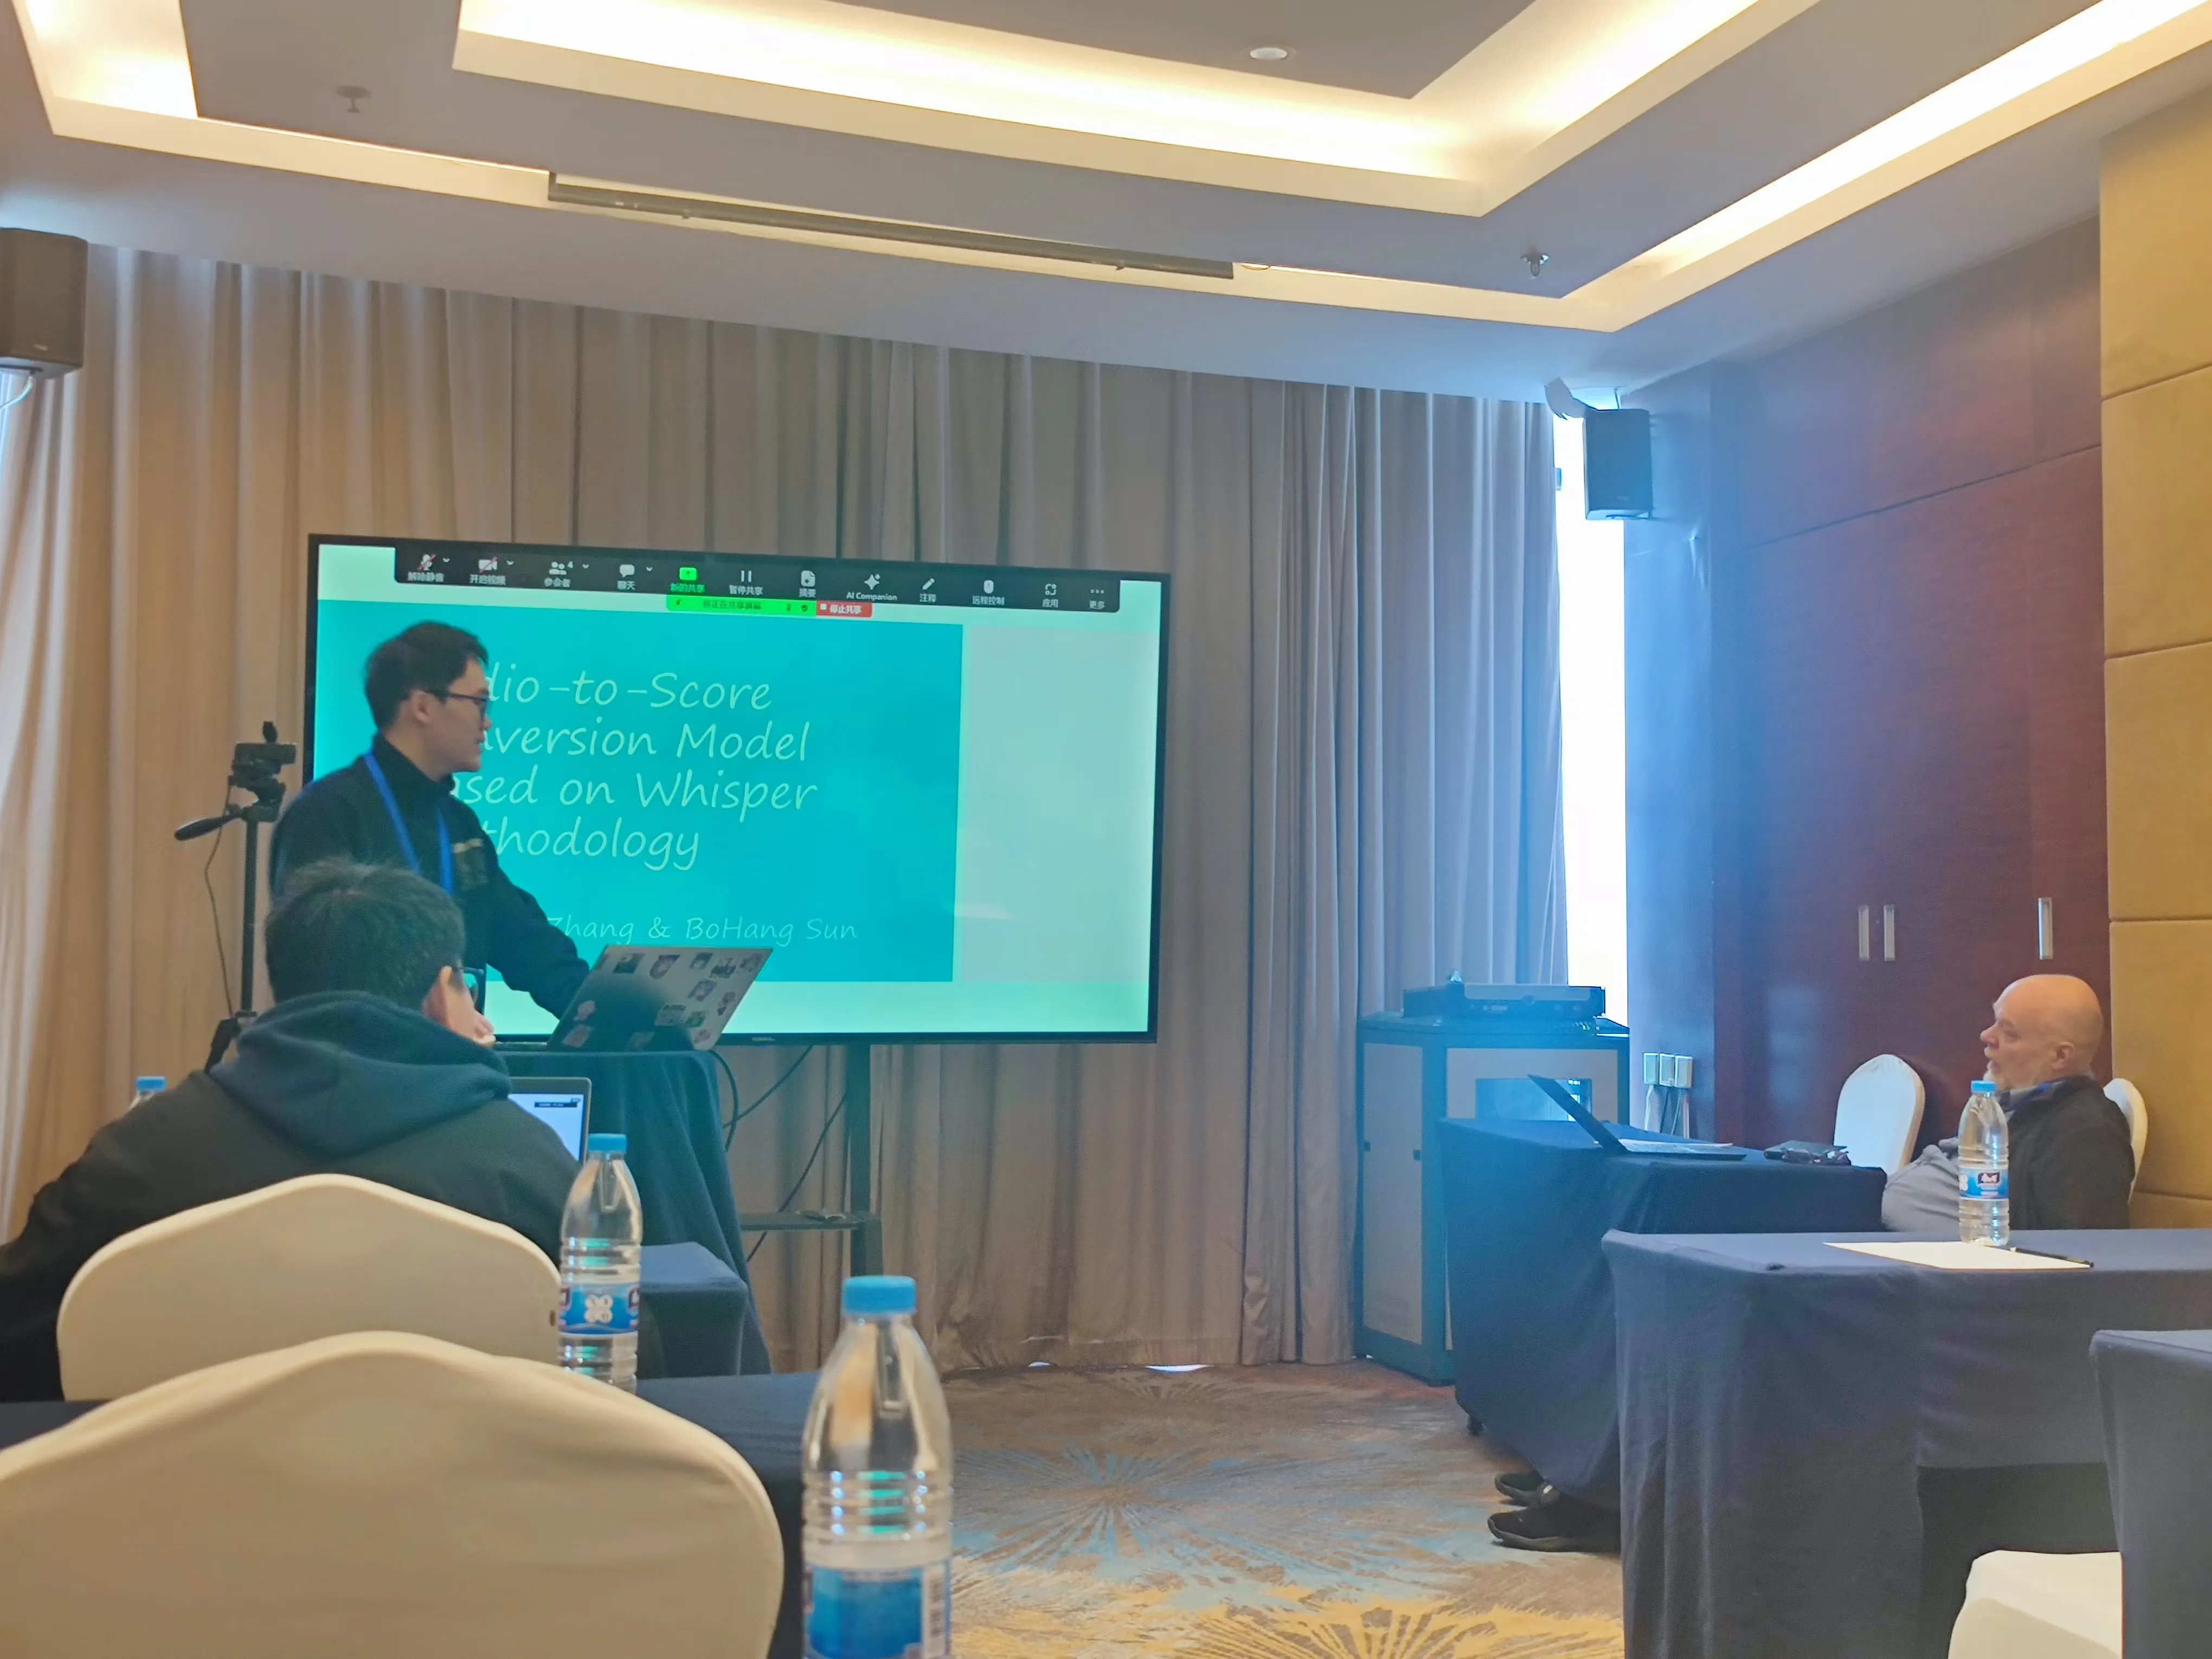
2024 年 8 月,我作为项目负责人前往英国剑桥参加 OxCam PBL(Project-Based Learning)项目。在项目中,我带领跨职能团队围绕“音频转乐谱”这一课题展开研究,基于 Whisper Encoder 架构设计并实现了一个 Transformer 音频转乐谱转换模型。项目结束后,我将研究成果进一步打磨,最终以会议论文形式发表于 IEEE PIC 2024。
研究背景
音频转乐谱(AMT)旨在将原始音频信号自动转换为可读乐谱,是音乐信息检索领域的核心问题之一。传统方法在处理多声部、复杂节奏的音频时准确率有限。随着 Transformer 架构在序列建模任务上的突破,基于注意力机制的端到端 AMT 方案成为可能。
技术方案
Whisper Encoder 特征提取
我们选择 Whisper 的编码器作为音频特征提取前端。Whisper 在大规模语音数据上预训练,其编码器对音频频谱特征具有较强的泛化能力,能够有效提取音高、音色等关键信息。
Transformer 解码器
在 Whisper Encoder 输出的特征序列基础上,我们设计了 Transformer 解码器,将音频特征逐步解码为乐谱 token 序列。模型通过 teacher forcing 方式训练,使用 MIDI 格式作为乐谱的中间表示。
数据处理
使用 Python 对音频数据集进行清洗与增强,包括采样率统一、静音裁剪、音高平移与时间拉伸等操作,以提升模型的泛化能力。
前端可视化界面
我独立设计并实现了项目的前端界面,用于展示音频输入与乐谱转换结果的对比,使研究成果能够以直观的方式呈现给评审人员。
论文发表
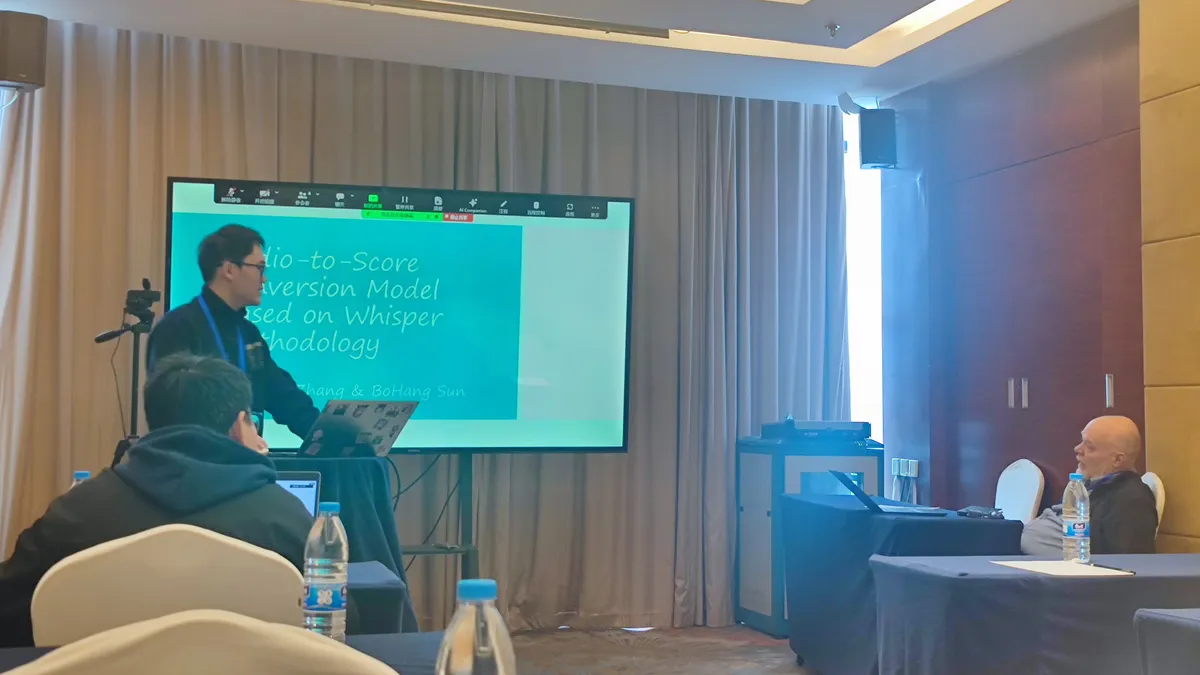
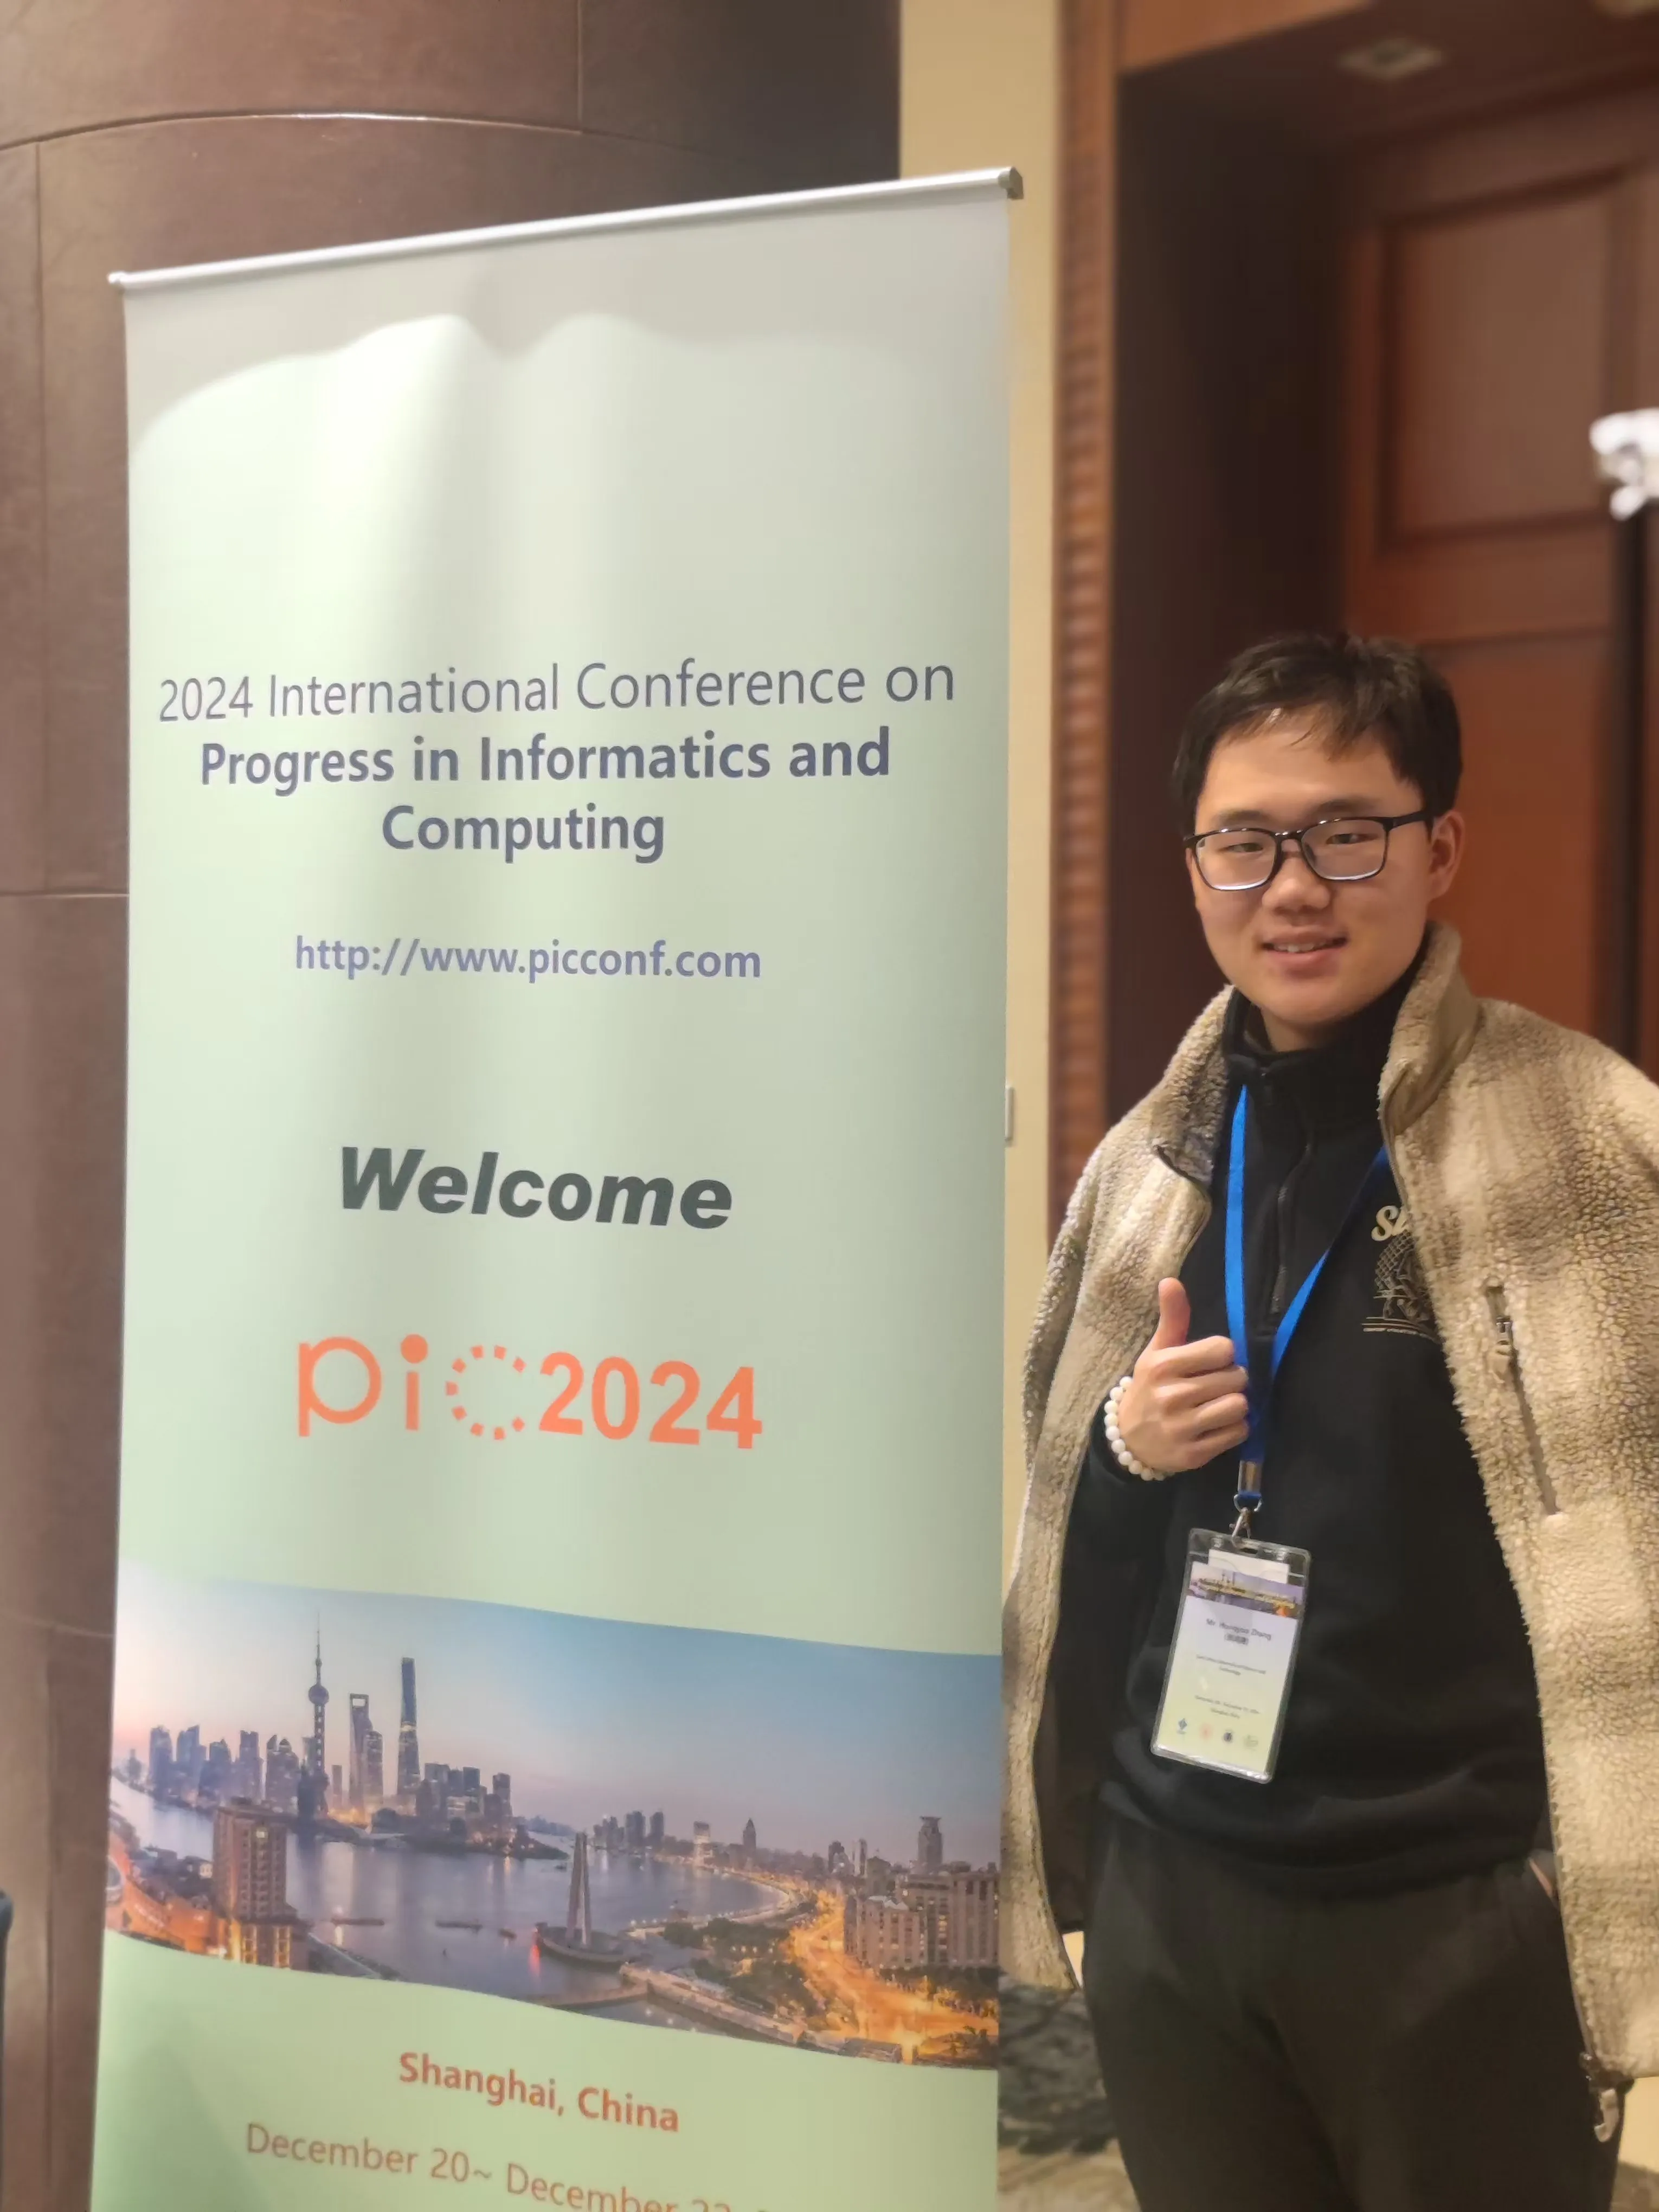
项目研究成果经进一步打磨后,发表于 2024 IEEE International Conference on Progress in Informatics and Computing (PIC):
Zhang, H., et al. (2024). “Audio-to-Score Conversion Model Based on Whisper Methodology.” 2024 IEEE International Conference on Progress in Informatics and Computing (PIC).
论文链接:IEEE Xplore