
项目概述
本项目旨在开发一个电子病历信息检索系统,解决现有电子病历文本检索准确率不高的问题。系统基于文本摘要的检索模型(TSIR),设计包含性别、年龄、身体部位、症状、疾病等信息的摘要模板,并采用大语言模型(ChatGLM)生成摘要。系统能生成电子病历和用户检索文本的摘要,利用 BERT 模型进行余弦相似度匹配,返回相似度较高的病历作为检索结果,同时集成病历上传、浏览、检索和论坛等功能。前端使用 Django,后端依赖 MySQL、MongoDB、NodeBB、NodeJS 和 Neo4j,兼顾高效处理与用户友好操作体验。
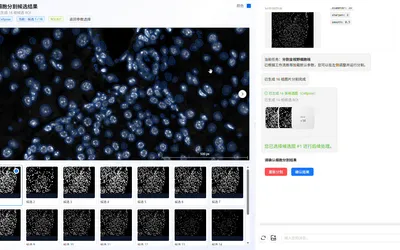
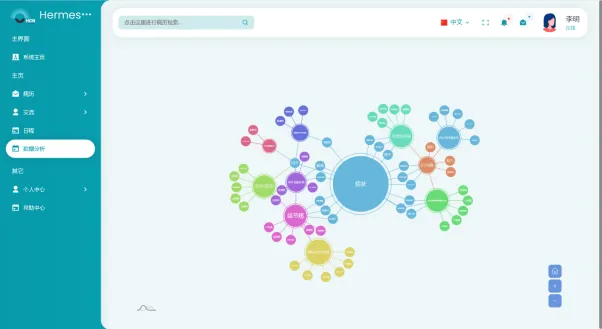
以下为系统主要功能演示:
技术方案
TSIR 模型
TSIR(Text Summarization based Information Retrieval)是面向医学文本的检索模型。该模型将“文本摘要生成”与“文本相似度计算”结合:先基于性别、年龄、身体部位、症状、疾病等字段设计摘要模板,再对电子病历和用户查询文本分别生成标准化摘要,过滤口语化噪声和非关键信息;随后使用 BERT 将摘要编码为向量,通过余弦相似度计算排序并返回相似度较高的病历。相比传统关键词匹配,该模型更关注语义层面的临床信息,显著提升检索准确率。
大语言模型集成
系统使用 ChatGLM 作为摘要生成与语义理解的核心。通过 prompt 提示词工程设计,模型从用户口语化主述中抽取关键医学实体,如性别、年龄、身体部位、症状、疾病等,并按照 TSIR 模板生成简洁、结构化的摘要。结合命名实体识别(NER)技术,系统可以更准确地识别复杂医学术语和临床描述;这些摘要是后续 BERT 语义匹配的基础,也为病历检索、相似病例对比和并发症推荐提供了支持。
竞赛成果
- 第十八届全国大学生软件创新大赛——软件设计创新赛华东区域赛 三等奖(2025年4月)
- 第十九届“挑战杯”全国大学生课外学术科技作品竞赛校内选拔赛 三等奖(2025年4月)
- 第二十六届中国机器人及人工智能大赛全国总决赛 二等奖(2024年8月)
- 第二十六届中国机器人及人工智能大赛上海赛区比赛 二等奖(2024年6月)
- 首届中欧青年人工智能大赛 二等奖(2024年6月)
- 上海市第十六届大学生计算机应用能力大赛 二等奖(2024年6月)
软件著作权已申请。
团队管理
作为项目负责人,我主导整体技术路线与 TSIR + LLM 方案设计,并组织项目启动、需求讨论和里程碑规划。根据成员背景进行分工:梁昱彬负责数据库获取处理及部分后端功能;陈豫昕负责前端页面设计与开发;周青莲负责 Django 整体结构搭建与前后端数据库联通。项目过程中通过定期会议同步进度、内部演示评审和模拟答辩,及时调整方案;同时推动系统测试、比赛备赛、文档撰写和软件著作权申请,确保项目在多个阶段按期交付。